OCR
Document AI
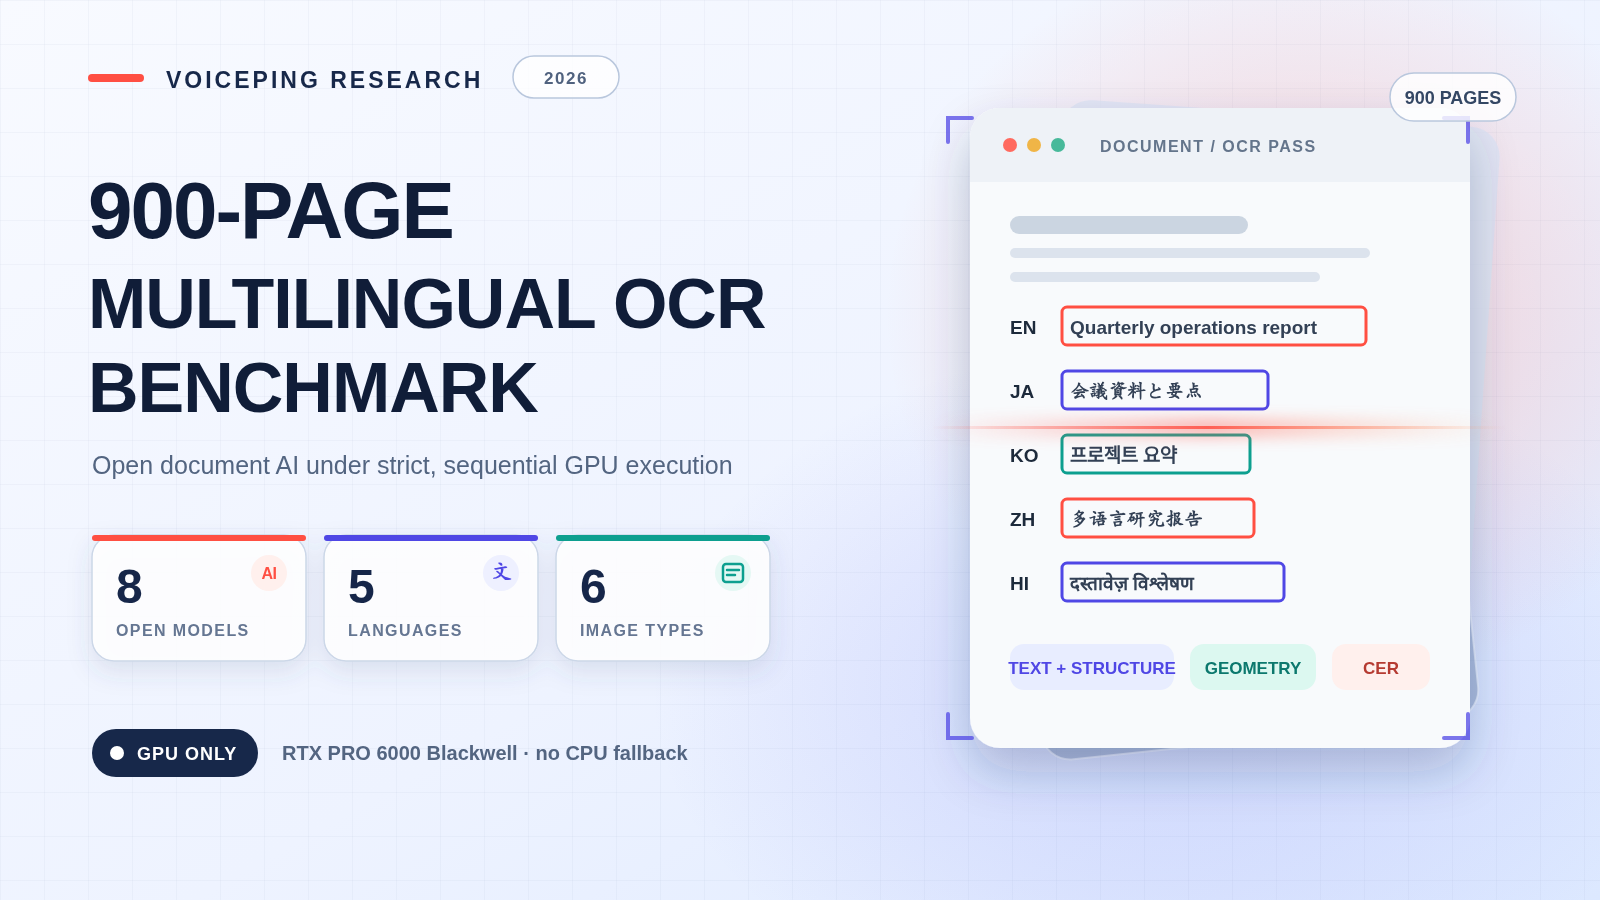
多语言 OCR 基准测试:Hunyuan 与 Qwen 领先准确率,Paddle 领先吞吐量
在严格 GPU-only 条件下,用覆盖五种语言、六类文档的 900 页数据评估八个开源 OCR 系统,并比较 CER、延迟、吞吐量、VRAM、能耗、截断和结构化输出。
VoicePing - Akash Verma
4 min
查看 VoicePing 的基准测试、研究方法、模型评估与产品研究。
37篇文章
在严格 GPU-only 条件下,用覆盖五种语言、六类文档的 900 页数据评估八个开源 OCR 系统,并比较 CER、延迟、吞吐量、VRAM、能耗、截断和结构化输出。
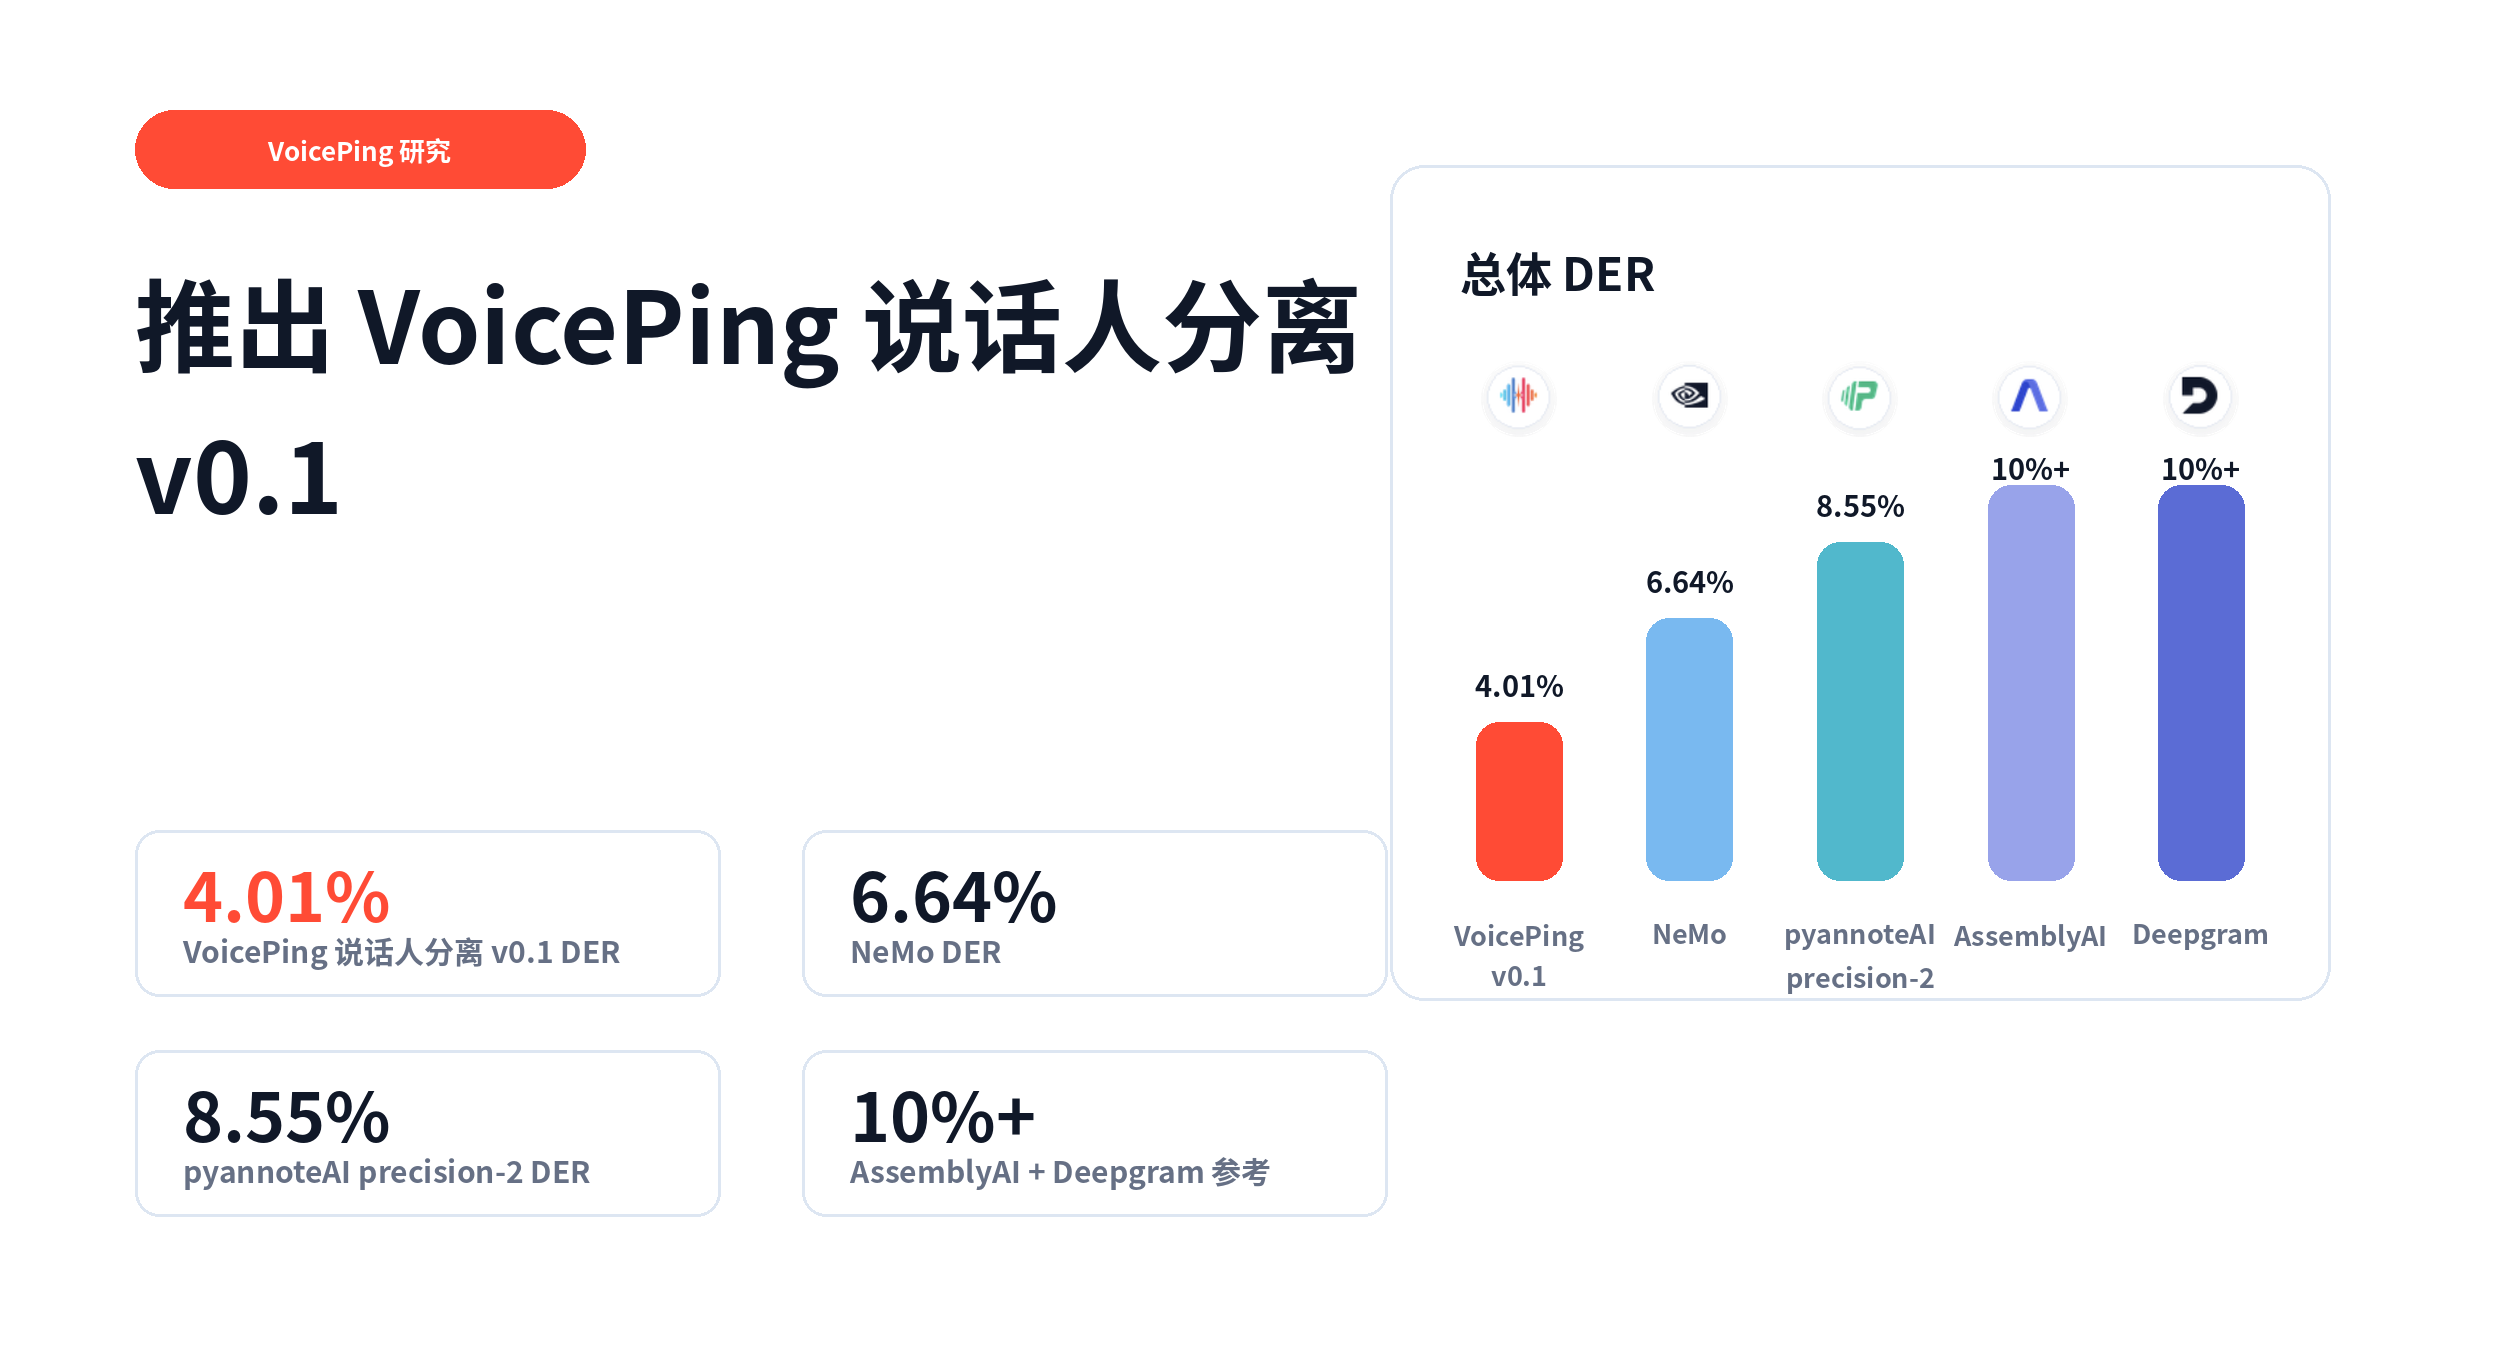
VoicePing Diarization v0.1 是一个多语言说话人分离模型。本次在 42 个文件的基准中与 NeMo、pyannoteAI precision-2、AssemblyAI 和 Deepgram 进行比较。
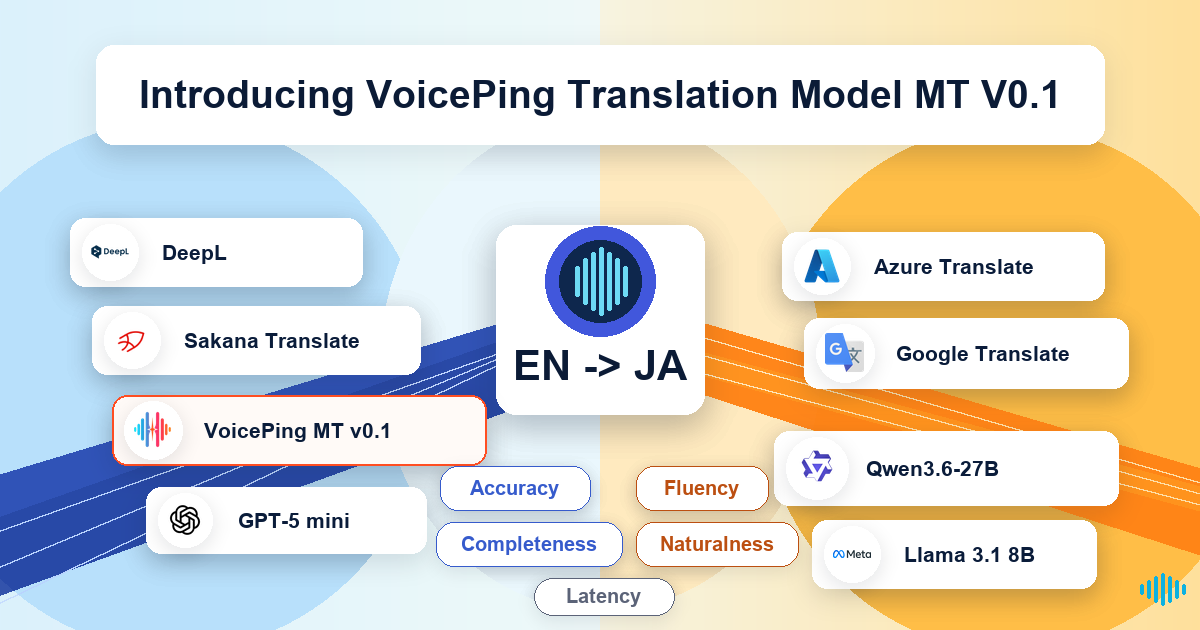
使用100条英日翻译数据和GPT-5.5评审,对DeepL、Sakana Translate、VoicePing MT v0.1、GPT-5 mini、Google翻译、Qwen、Azure和Llama进行质量与观测延迟比较。
正式发布 VoicePing ASR Model V0.1——一款支持英语、日语、韩语、中文和越南语的多语言语音转文字模型。
面向日语和中文六种目标情绪,对五个情感文本转语音模型进行 SenseVoice、emotion2vec 锚点、CER、自然度、运行时间和试听样本评估。

英日双向语音翻译模型基准测试。将 Qwen3-ASR(1.7B 参数,最高质量)和 Distilled Whisper(756M,快 4 倍)与 OpenAI Whisper large-v3 及 Meta SeamlessM4T v2 进行比较。